Concepto y contexto
Encoding, hashing y cifrado transforman datos con objetivos distintos y confundirlos provoca errores de seguridad e interoperabilidad.
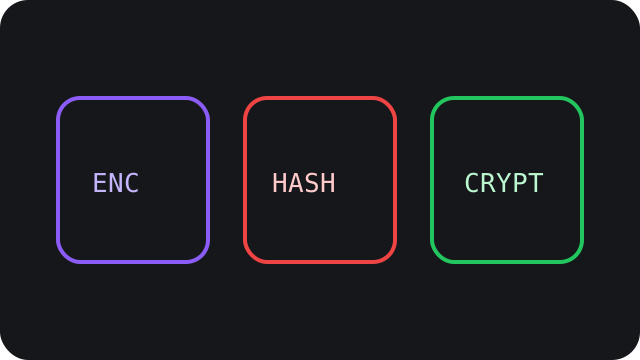
Encoding cambia la representación, hashing obtiene un digest y el cifrado protege confidencialidad mediante una clave.
Un buen modelo mental separa el concepto abstracto de su representación concreta y del entorno donde se utiliza. Esa separación evita trasladar automáticamente supuestos válidos en un protocolo, biblioteca o formato hacia sistemas que pueden aplicar reglas o garantías diferentes.
Fundamentos y terminología
Base64 es reversible y no usa secreto; SHA-256 es una función hash determinista diseñada como unidireccional; AES es un cifrador simétrico con clave.
HMAC combina una hash con secreto compartido para aportar autenticidad e integridad.
La terminología debe leerse junto con el estándar, versión o contrato que la define, porque palabras parecidas pueden describir propiedades distintas según la capa. Explicitar esas definiciones mejora interoperabilidad, documentación y capacidad para diagnosticar comportamientos inesperados.
Cómo funciona
Encoding mapea bytes a un alfabeto adecuado para el canal, hashing comprime entradas arbitrarias a una salida fija y el cifrado convierte plaintext en ciphertext.
La seguridad también depende de gestión de claves, modo, nonce y protocolo completo.
En sistemas reales conviene seguir el recorrido de los datos entre capas e identificar qué transformaciones son reversibles, cuáles introducen restricciones y dónde puede perderse información. Así resulta más sencillo razonar sobre responsabilidades entre productores, consumidores, almacenamiento y transporte.
Ejemplo razonado
Un adjunto binario puede codificarse Base64 para viajar en JSON, verificarse con SHA-256 tras la transferencia y cifrarse con un algoritmo autenticado si necesita confidencialidad.
Las tres operaciones pueden coexistir porque resuelven problemas distintos.
Un ejemplo razonado es reutilizable cuando muestra sus precondiciones e invariantes y no solo el resultado final. Cambiar un supuesto cada vez permite distinguir el comportamiento garantizado por un estándar de las decisiones particulares de una aplicación o implementación.
Errores y conceptos equivocados
Base64 no oculta información y una hash rápida de propósito general no protege contraseñas frente a intentos masivos.
Cifrar sin autenticación puede permitir manipulación, y reutilizar nonce donde está prohibido puede destruir garantías criptográficas fuertes.
Muchos fallos nacen de supuestos implícitos entre sistemas aparentemente compatibles que usan versiones, reglas de canonicalización o modelos de tipos diferentes. En interoperabilidad y seguridad conviene especificar y probar entradas anómalas en lugar de tratarlas como casos irrelevantes.
Buenas prácticas y criterios de elección
Empieza nombrando la propiedad requerida: compatibilidad de transporte, integridad, autenticidad o confidencialidad.
Usa primitivas estándar y bibliotecas maduras, password hashing específico y cifrado autenticado cuando debas impedir lectura y modificación.
Una práctica robusta combina estándares documentados, bibliotecas maduras, contratos explícitos y pruebas con casos límite representativos. La mejor elección no es siempre la más breve o popular: también cuentan portabilidad, legibilidad, rendimiento, seguridad, evolución y coste operativo.