URI, URL y componentes
URI es el término general para identificadores de recursos; URL describe URI que además indican un mecanismo o lugar de acceso. En la web suelen distinguirse scheme, authority, path, query y fragment, cada uno con reglas propias.
Los límites importan porque un carácter puede ser sintaxis en una posición y dato en otra. Codificar indiscriminadamente un URL completo puede destruir delimitadores necesarios.
Caracteres reserved y unreserved
RFC 3986 distingue caracteres unreserved, que normalmente pueden aparecer literalmente, y reserved, que pueden actuar como delimitadores. Letras ASCII, dígitos, guion, punto, underscore y tilde son unreserved.
Caracteres como :, /, ?, #, [, ], @ y varios sub-delimiters pueden aportar estructura. Codificarlos como datos depende del componente concreto en el que aparecen.
De texto Unicode a bytes UTF-8
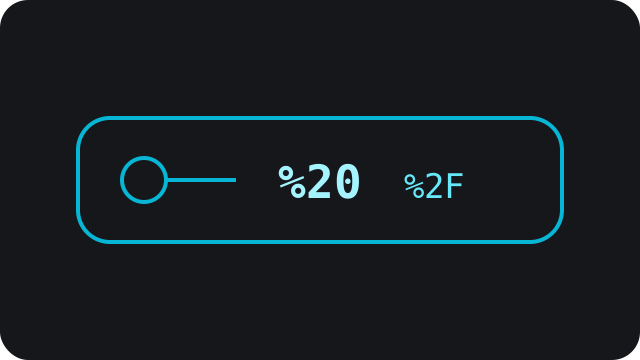
El percent-encoding representa bytes: cada byte se expresa con % y dos dígitos hexadecimales. Un carácter Unicode no ASCII se transforma primero a UTF-8 y puede generar varios bytes y varias secuencias %HH.
Por eso un solo carácter visible puede expandirse mucho. Una decodificación correcta reconstruye primero los bytes y después los interpreta con el encoding acordado, normalmente UTF-8.
Path, query y form encoding
En un path, las barras y segmentos tienen significado estructural. En una query, ampersand e igual se usan habitualmente para pares nombre-valor, aunque la sintaxis URI no impone un único modelo universal de datos de consulta.
application/x-www-form-urlencoded añade una convención distinta: el espacio suele representarse con + y un signo + literal debe codificarse. No debe confundirse con el percent-encoding genérico de URI.
Normalización y equivalencia
Los dígitos hexadecimales del percent-encoding no distinguen mayúsculas y minúsculas, y algunos caracteres unreserved codificados pueden normalizarse a forma literal. Aun así, dos URL textualmente distintos no son siempre equivalentes.
La normalización de host, puertos por defecto, path y query depende del protocolo y del servidor. Evita reescrituras agresivas cuando la identidad exacta o una firma criptográfica dependan de la representación original.
Errores de decodificación y seguridad
Secuencias de porcentaje incompletas, dígitos no hexadecimales o bytes que no forman UTF-8 válido deben tratarse explícitamente. Decodificadores permisivos pueden provocar interpretaciones distintas entre proxy, framework y aplicación.
Las diferencias de canonicalización pueden facilitar bypass de routing, cache o validaciones. Decodifica en la capa correcta, evita decodificaciones repetidas y valida después cada componente según su semántica.