Concetto e contesto
UUID identifica valori a 128 bit con layout e versioni standardizzate, ma versioni diverse incorporano informazioni e proprietà operative differenti.
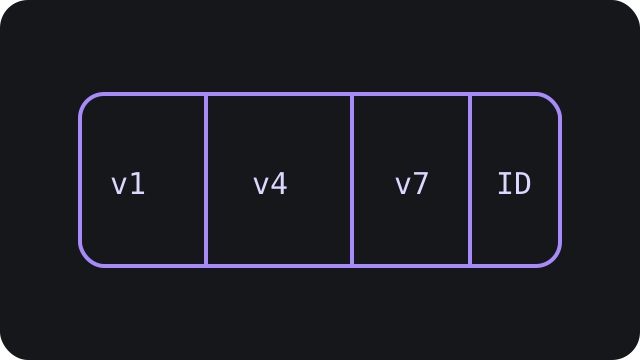
v1 è time-based con componenti storicamente legati al nodo, v4 è casuale e v7 combina tempo Unix in millisecondi con bit casuali.
Per inquadrare correttamente il tema conviene distinguere sempre il concetto astratto dalla sua rappresentazione concreta e dal contesto in cui viene utilizzato. Questa separazione evita di trasferire automaticamente assunzioni valide in un protocollo, una libreria o un formato verso ambienti che possono applicare regole differenti.
Fondamenti e terminologia
Version e variant sono codificati in bit specifici e non tutta la capacità dei 128 bit è disponibile come entropia.
UUID v4 offre un enorme spazio casuale, mentre v7 produce valori che tendono a ordinarsi temporalmente e sono più adatti a indici dove la località di inserimento conta.
La terminologia va letta insieme allo standard, alla versione o al contratto che la definisce: parole simili possono indicare proprietà diverse a seconda del livello considerato. Rendere esplicite queste definizioni migliora interoperabilità, documentazione e capacità di diagnosticare risultati inattesi.
Come funziona
La generazione v4 richiede un generatore casuale adeguato; v7 costruisce il prefisso temporale e completa il valore con casualità e regole per gestire più ID nello stesso millisecondo.
v1 incorpora timestamp e clock sequence e può esporre più metadati del necessario.
Nel funzionamento reale è utile seguire il percorso dei dati attraverso i diversi livelli, osservando quali trasformazioni sono reversibili, quali introducono vincoli e dove può andare persa informazione. Questo modello rende più semplice stabilire responsabilità tra producer, consumer, storage e rete.
Esempio ragionato
In un database distribuito v4 evita coordinamento e rende improbabili collisioni, ma produce inserti casuali negli indici.
v7 mantiene decentralizzazione e offre ordinamento approssimativo per tempo, riducendo frammentazione in molti workload senza trasformare l'ID in un contatore globale.
Un esempio è davvero riutilizzabile quando chiarisce non soltanto il risultato finale, ma anche le precondizioni e le proprietà che restano invarianti. Cambiando un'assunzione alla volta si può capire quali parti dell'esempio appartengono allo standard e quali sono invece scelte applicative.
Errori e misconception
Un UUID valido non prova che una risorsa esista né autorizza accesso, e la probabilità bassa di collisione non elimina la necessità di vincoli unique.
Usare UUID come segreto è inoltre scorretto: identificazione e autenticazione sono proprietà separate.
Molti errori nascono da assunzioni implicite tra sistemi che sembrano compatibili ma adottano versioni, canonicalizzazioni o modelli di tipo differenti. Nei casi di interoperabilità o sicurezza conviene quindi trattare gli input anomali come casi da specificare e testare, non come eccezioni trascurabili.
Best practice e criteri di scelta
Scegli la versione in base a privacy, ordinamento, compatibilità e comportamento dello storage.
Genera con librerie standard, conserva il tipo nativo quando il database lo supporta e non dipendere dall'ordine lessicografico senza verificare come la rappresentazione scelta ordina i byte.
Una pratica robusta combina standard documentati, librerie mature, contratti espliciti e test con casi limite rappresentativi. La scelta migliore non è sempre quella più compatta o diffusa: va valutata rispetto a portabilità, leggibilità, prestazioni, sicurezza, evoluzione e costo operativo.